
相关性分析怎么读:从皮尔逊系数到方差分析
把数据拼成一张表之后,下一步就是问:"这几个变量之间到底有没有关系?"
这学期两个分析作业都做了相关性分析,但算出来一堆数字之后我发现——比"会算相关系数"更重要的,是知道什么情况下算出来的数不能信。这篇笔记记的就是这件事。
皮尔逊相关系数怎么读
最常用的是皮尔逊相关系数(Pearson correlation coefficient),记作 r,取值范围 -1 到 1:
| r 的范围 | 含义 |
|---|---|
| r > 0 | 正相关,一个变大另一个也变大 |
| r < 0 | 负相关,一个变大另一个变小 |
| |r| 越接近 1 | 关系越强 |
| r = 0 | 没有线性关系(注意不是"没有关系") |
最后一行是个陷阱:皮尔逊系数只能捕捉线性关系。如果两个变量是 U 型关系(比如温度和使用量——太冷太热都少),r 可能接近 0,但它们其实高度相关。所以在算 r 之前,先画散点图看一眼,是非常必要的步骤。
代码
nc = df.select_dtypes(include=[np.number]).columns
cm = df[nc].corr()

for target, name in [('AQI年均值', 'AQI'), ('PM2_5年均值_ugm3', 'PM2.5')]:
    print(f"\n{name} Pearson correlations:")
    for col, val in cm[target].drop(target).sort_values().items():
        s = '***' if abs(val)>0.7 else ('**' if abs(val)>0.5 else ('*' if abs(val)>0.3 else ''))
        print(f"  {col}: r={val:.4f} {s}")
几个写法上的细节:
select_dtypes(include=[np.number]) 只取数值列。如果直接对整个 DataFrame 求相关,遇到中文文本列(城市名、区域)会直接报错。
.drop(target) 把目标变量自己去掉——它和自己的相关系数当然是 1.0,留着是干扰项。
.sort_values() 升序排列。这样一眼就能看到最强的负相关(排最前)和最强的正相关(排最后),比看乱序的结果高效得多。
那串星号是自己定的显著性标记(|r| > 0.7 三星、> 0.5 两星、> 0.3 一星)。这是自定义的经验规则,不是统计学的标准——正式报告里应该用 p 值来判断显著性。
案例一:宽带渗透率与互联网使用率
全球互联网项目里最核心的一个发现:
固定宽带订阅量(每百人)与互联网使用率(%)的皮尔逊相关系数 r = 0.8539,R² = 0.729,p < 0.001。
怎么解读这三个数:
r = 0.8539 是强正相关——宽带普及度越高的国家,上网的人越多。这个结论符合直觉,但它把直觉量化了。
R² = 0.729 更值得注意。R² 叫决定系数,含义是"一个变量的变异能被另一个变量解释的比例"。0.729 意味着仅凭宽带这一个指标,就能解释各国互联网普及率差异的 72.9%。
这是个相当高的解释力。也就是说,虽然影响互联网普及的因素很多(经济发展、教育水平、政策……),但宽带基础设施这一个变量就占了大头。
p < 0.001 说明这个相关性在统计上极显著——不是偶然出现的。
对比:其他三个指标
| 指标对 | r | 解读 |
|---|---|---|
| 使用率 — 宽带 | 0.8539 | 强 |
| 使用率 — 移动订阅 | 0.6048 | 中等偏强 |
| 使用率 — 用户总数(log) | 0.2853 | 弱 |
这张表本身就是一组结论:
移动订阅只有 0.6048,比宽带低了 0.25。按常识,现在人人都有手机,移动网络应该比宽带更普及才对。但数据说明——有手机 ≠ 能上网。报告里提到一个细节:低使用率组(使用率 0-20%)的国家,移动订阅中位数已经达到 70/100 人,但宽带中位数只有 0.3/100 人。手机覆盖率不低,缺的是宽带基础设施。
用户总数(取对数后)只有 0.2853。这个最反直觉——用户多的国家不是上网率高的国家吗?
不是。中国有 7 亿多互联网用户,使用率约 50%;印度 4 亿多用户,使用率约 30%。绝对人数多是因为人口基数大,跟普及程度是两回事。
这引出一条做国际比较时的通用原则:比"总量"还是比"比率",结论可能完全相反。要比较发展水平,用比率(%);要评估市场规模,用总量。混用会得出荒谬结论。
案例二:一个"不能信"的相关系数
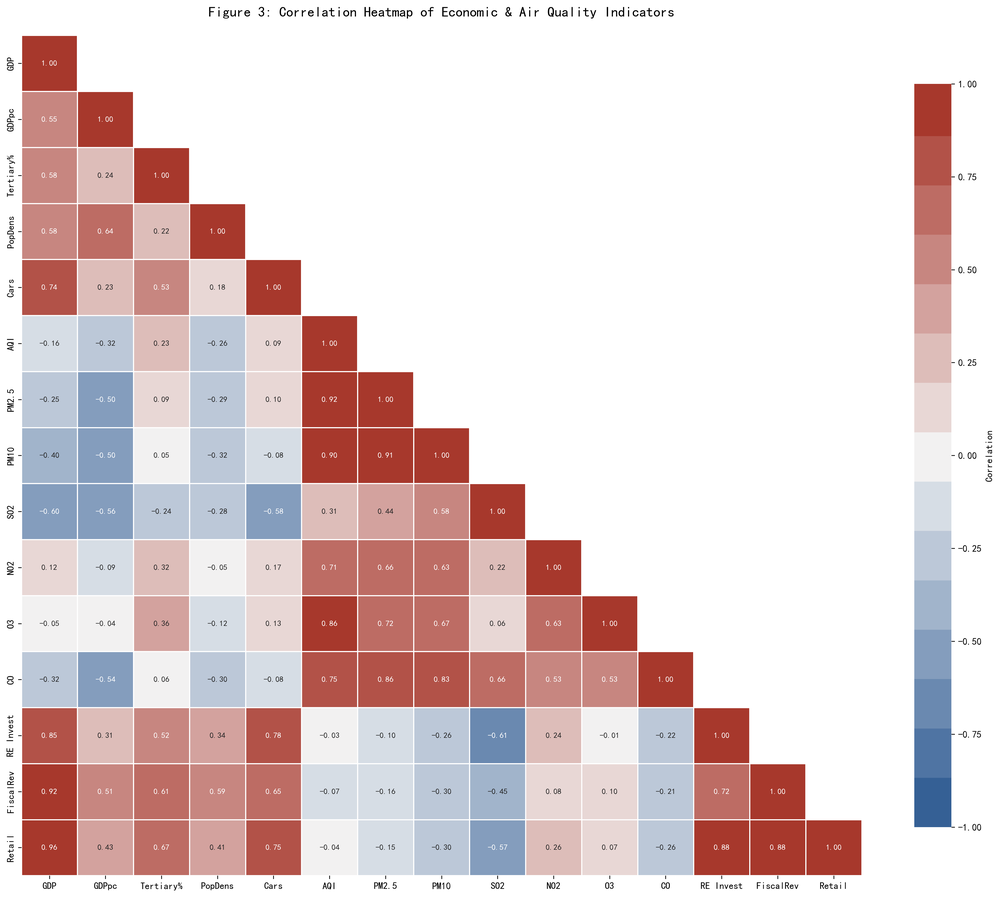
城市项目里,AQI 与其他指标的相关系数中,最高的是这个:
年优良天数比例_pct 与 AQI 年均值的相关系数 r = -0.9752
|r| = 0.9752,几乎完美负相关。按前面的标记规则,这是三星强相关。看到这个数字,第一反应是"发现了一个极强的规律"。
但这个相关系数没有意义。
因为 AQI(空气质量指数)的定义本身就是由污染物浓度算出来的,而"优良天数"又是按 AQI 是否低于某个阈值来判定的。这两个指标是同一套标准的两个侧面——它们的相关性是定义带来的,不是数据揭示的。
这种叫机械相关(也有人叫"伪相关"或"自相关")。它必然出现,不构成任何发现。如果把它写进报告当作结论,等于说"天气好的天数多,说明空气质量好"——这是同义反复。
怎么识别这类陷阱?我总结了三条:
一、看两个指标是不是同一个东西的不同表达。"优良天数"和"AQI"、"体重"和"BMI"、"销售额"和"销售数量×单价"——这些都属于同一族。
二、看一个是不是由另一个算出来的。派生指标和原始指标之间的相关性没有信息量。
三、问一句"这个结论如果成立,会让人惊讶吗"。如果答案是"这不是废话吗",那大概率是机械相关。
把这条剔除之后,AQI 与其他污染指标的相关性才是有价值的发现:
| 指标 | r | 说明 |
|---|---|---|
| PM2.5 | +0.9240 | 强正相关 |
| PM10 | +0.8989 | 强正相关 |
| O3 | +0.8600 | 强正相关 |
| CO | +0.7544 | 强正相关 |
| NO2 | +0.7068 | 强正相关 |
| SO2 | +0.3142 | 弱 |
这些是有意义的——它们说明在 20 个样本城市里,PM2.5 是驱动 AQI 的主要污染物(r 最高),而 SO2 的影响相对独立。
更重要的发现:什么时候"没有关系"
城市项目里最值得写进报告的,其实是一堆不显著的结果:
| 变量对 | r | p 值 | 结论 |
|---|---|---|---|
| GDP — AQI | -0.1612 | 0.4972 | 不显著 |
| 第三产业占比 — PM2.5 | +0.0853 | 0.7208 | 不显著 |
| 汽车保有量 — PM2.5 | +0.0980 | 0.6810 | 不显著 |
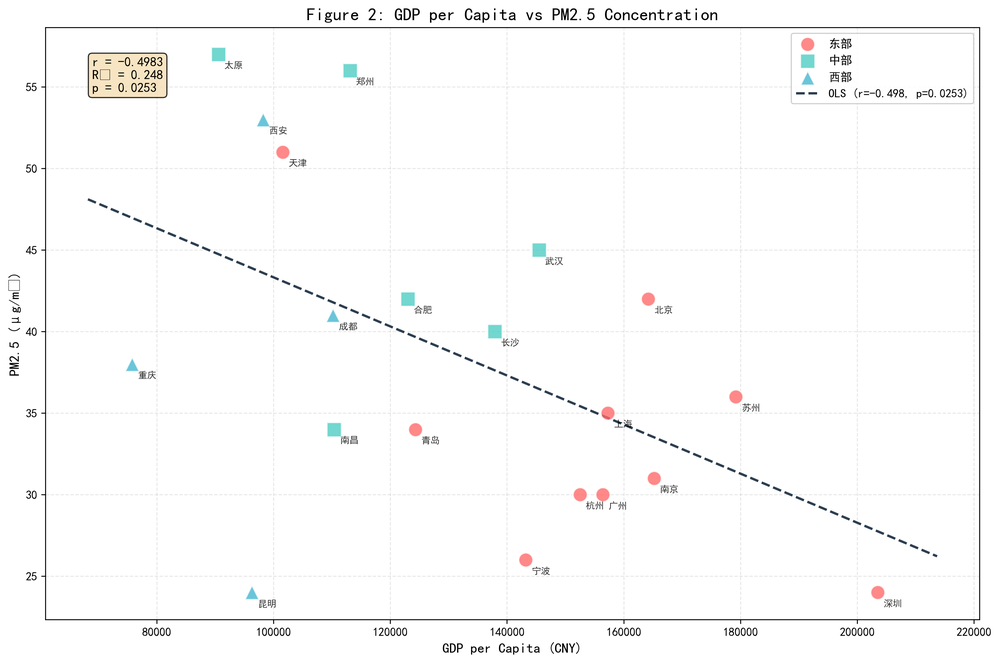
| 人均 GDP — PM2.5 | -0.4983 | 0.0253 | 显著 |
前三行都是"没找到关系"。第四行是唯一显著的经济-环境关系:人均 GDP 越高,PM2.5 越低(r = -0.4983,中等强度负相关)。
注意 GDP 总量不显著、人均 GDP 显著这个对比。这又一次说明总量指标和人均指标不能混用——GDP 总量大可能只是城市规模大,而人均 GDP 才反映发展水平。用错指标,结论就从"有关系"变成"没关系"。
不显著不等于没关系
这里要特别小心一个理解误区。p = 0.4972 的正确解读是:"在 20 个样本的规模下,没有足够证据认为 GDP 和 AQI 存在线性关系"。
它不等于"GDP 和 AQI 无关"。原因可能有很多:样本量太小(只有 20 个城市)、关系是非线性的(可能存在"先污染后治理"的倒 U 型曲线)、或者被其他变量掩盖了。
20 个样本做相关性分析,统计功效是很有限的。不显著的结果应该被报告,但不能被当成"证明无关"的结论。
方差分析:从"相关"到"分组差异"
相关性分析回答的是"两个连续变量有没有关系"。但有时候要问的是另一个问题:"分成几组之后,组与组之间有没有显著差异?"
比如:东部、中部、西部的空气质量,差异是真实存在的,还是样本波动?这就要用方差分析(ANOVA)。
gpm = [df[df['区域']==r]['PM2_5年均值_ugm3'] for r in ORD]
fp, pp = f_oneway(*gpm)
print(f"Regional PM2.5 ANOVA: F={fp:.4f}, p={pp:.4f} {'*' if pp<0.05 else 'NS'}")

ggdp = [df[df['区域']==r]['GDP_亿元'] for r in ORD]
fg, pg = f_oneway(*ggdp)
print(f"Regional GDP ANOVA: F={fg:.4f}, p={pg:.4f} {'*' if pg<0.05 else 'NS'}")
代码很短,关键在理解 f_oneway 的参数形式:它接收多个数组,每个数组是一组数据。所以先用列表推导式把三个区域的数据拆成三组,再用 * 展开传进去。
结果很有意思:
| 检验 | F 值 | p 值 | 结论 |
|---|---|---|---|
| 区域 × PM2.5 | 3.1475 | 0.0687 | 不显著 |
| 区域 × GDP | 4.0524 | 0.0364 | 显著 |
区域之间的经济发展水平有显著差异,但空气质量没有。
这个结论乍看和直觉相反(一般会觉得东部空气差、西部空气好)。但看区域均值就明白了:
| 区域 | 人均 GDP(元) | PM2.5 | 优良天数比例 |
|---|---|---|---|
| 东部 | 154,740 | 33.90 | 77.57% |
| 中部 | 120,083 | 45.67 | 68.32% |
| 西部 | 95,125 | 39.00 | 81.18% |
规律确实存在:东部经济最强、空气较好;中部经济居中、空气最差;西部经济最弱、空气最好。
但中部"空气最差"这个偏离,把区域差异的整体显著性拉低了——所以 ANOVA 判为不显著。如果只看东、西两组的对比,结论可能完全不同。
这就是统计检验的价值:它能拦住"看起来有规律"但其实站不住的结论。光看均值表,很容易得出"空气质量存在区域差异"的印象;ANOVA 告诉你,在 20 个样本的规模下这个差异还不够显著。
两张图
下面两张是城市项目实际跑出来的结果。
几条经验
整理完这两个项目,我觉得相关性分析里最难的不是算,是判断什么时候不该信。
先看图,再算数。皮尔逊系数只捕捉线性关系,散点图却能看出 U 型、聚集、离群点这些 r 反映不了的信息。跳过这一步直接算系数,很容易得出一个"看着很准"的错误结论。
警惕机械相关。如果两个指标本质上是同一个东西的不同表达(比如 AQI 和优良天数比例,r = -0.9752),相关系数再高也没有信息量。判断方法:问自己"这个结论如果成立,会让人惊讶吗"——不惊讶的,大概率是同义反复。
不显著的结果也要报告,但别过度解读。p 值大只说明"证据不足",不说明"确实无关"。尤其在 20 个样本这种规模下,统计功效本来就有限,不显著几乎是必然的——把不显著读成"证明无关",是另一种常见的错误。
还有一条贯穿的:相关不等于因果。这两个项目里没有一个结论能证明因果,只能说"存在关联"。比如"人均 GDP 高的城市 PM2.5 低"这个发现,背后的机制可能是产业转移、可能是环保投入更多、也可能只是这 20 个城市恰好如此——数据本身回答不了。要论证因果需要实验设计或更严格的因果推断方法,不是算个相关系数就够的。
暂无评论