
Django + ECharts:农产品数据可视化大屏
做农产品平台这个项目时,老师提的第一个要求是"要能看出数据"。后台光有增删改查的表格不够,得有一个能直观看出分布、趋势、排行的看板。
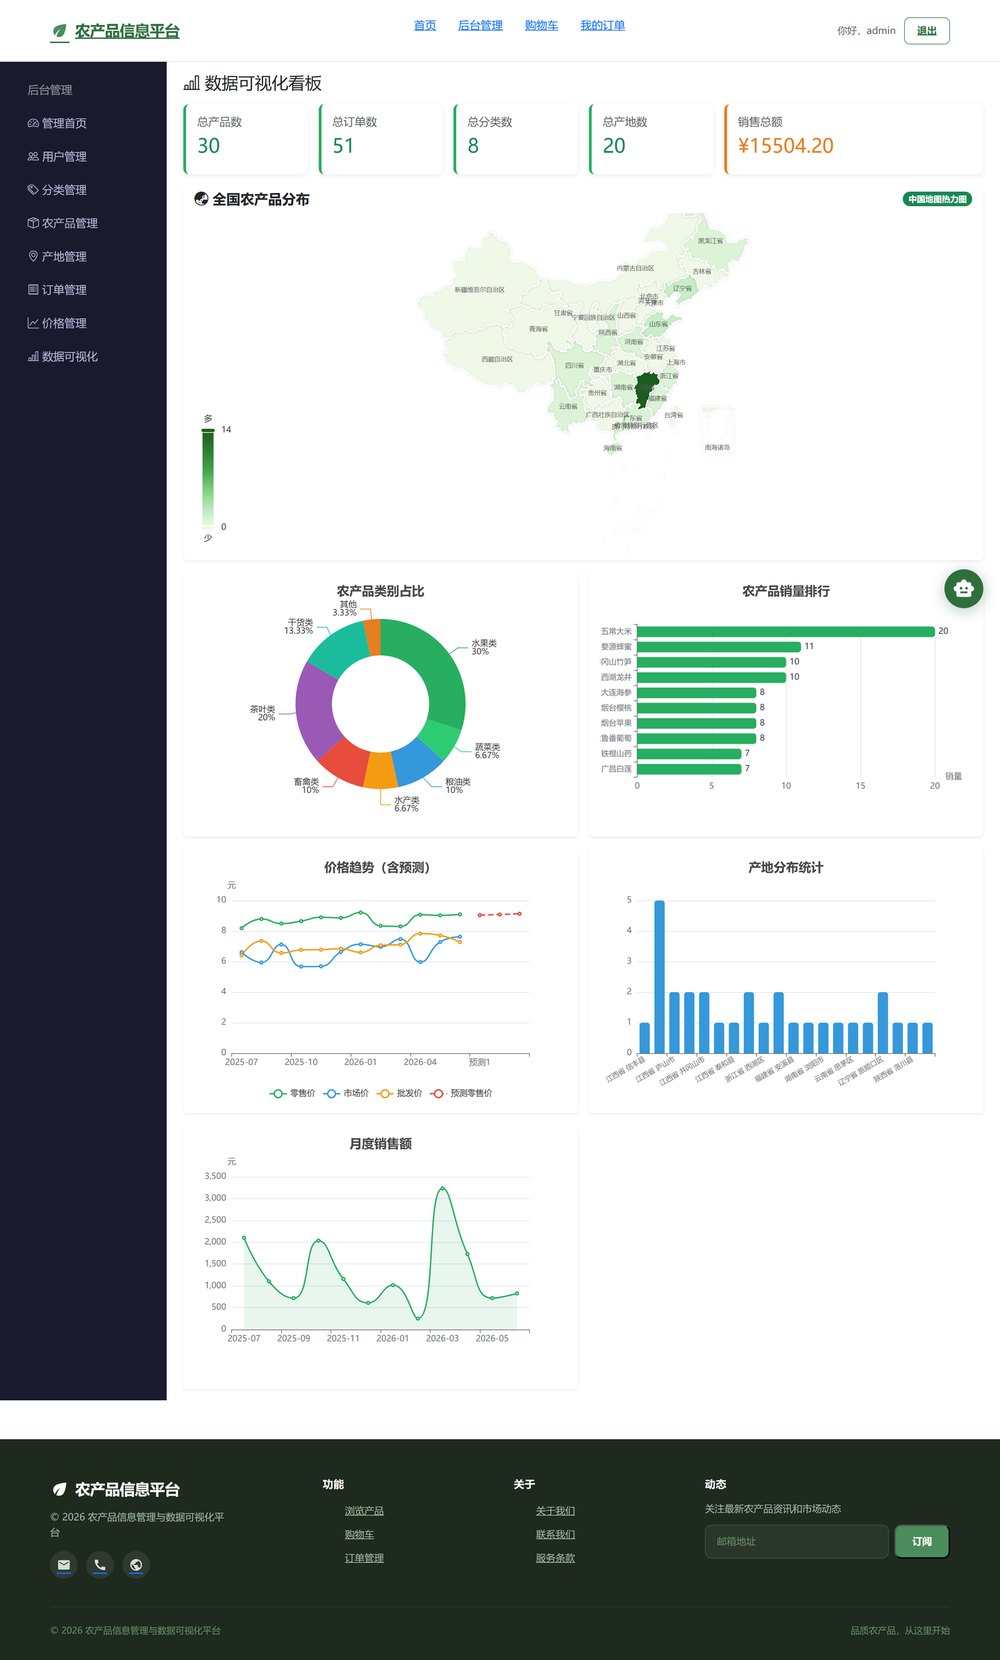
最后做出来的是 6 张图表:一张中国地图热力图,加上饼图、横向柱状图、多系列折线图、纵向柱状图、面积图各一张。这篇文章讲它的架构和实现。
整体架构:服务端只出数据
最容易想到的做法是在 Django 模板里用 {% for %} 循环渲染数据,把图表直接画成 HTML。但图表不行——ECharts 需要在浏览器里跑,数据必须是运行时可获取的。
所以我把它拆成两层:
浏览器                    Django 服务端
  │
  ├─ GET /admin/dashboard/ ──→ 渲染页面骨架(5 个统计卡片的数字)
  │                              ↑ 服务端直接算好,写进 HTML
  │
  ├─ GET /api/category-pie ──→ {"data": [{"name":"水果","value":8}, ...]}
  ├─ GET /api/sales-ranking ─→ {"data": [...]}
  ├─ GET /api/price-trend ───→ {"data": {...}}
  │  ... 共 6 个接口
  │
  └─ ECharts 拿到数据后画图
顶部的统计卡片走服务端渲染,下面的图表走 AJAX。两种方式混用是有意的:
统计卡片是 5 个纯数字(产品总数、订单总数等),服务端渲染最快——页面一打开就能看到,不需要等 JS 执行。图表则必须有 JS,反正要等,那就异步取数据,让页面骨架先出来。
服务端:一个视图 + 7 个接口
页面视图只做一件事——把 5 个统计数字放进 context:
@login_required
@admin_required
def dashboard_view(request):
    from apps.products.models import Product, Category, Origin
    from apps.orders.models import Order
    from django.db.models import Sum

    total_sales = Order.objects.filter(
        status__in=['paid', 'shipping', 'shipped', 'completed']
    ).aggregate(total=Sum('total_amount'))['total'] or 0

    context = {
        'total_products': Product.objects.count(),
        'total_orders': Order.objects.count(),
        'total_categories': Category.objects.count(),
        'total_origins': Origin.objects.count(),
        'total_sales': round(float(total_sales), 2),
    }
    return render(request, 'admin/dashboard.html', context)
注意 total_sales 的计算:它只统计已支付及之后状态的订单。
订单有六种状态:待支付、已支付、待发货、已发货、已完成、已取消。如果把待支付的也算进销售额,那些下了单没付钱的会虚增数字;把已取消的算进去更荒唐。所以用 status__in 白名单,只取真实成交的四种。
另外 or 0 这个兜底不能省——如果一张订单都没有,aggregate() 返回的是 None,直接传给模板会因为类型错误而报错。
6 个数据接口
每个图表对应一个接口,结构完全一致:
@login_required
@admin_required
def api_category_pie(request):
    return JsonResponse({'data': services.get_category_pie()})
统一用 {'data': ...} 包一层,前端就能统一写 const {data} = await res.json()。这个约定看着多余,但省掉了每个接口各写一套解析逻辑的麻烦。
两个装饰器叠在一起:@login_required 是 Django 内置的,管"有没有登录";@admin_required 是自己写的,管"是不是管理员":
def admin_required(view_func):
    def wrapper(request, *args, **kwargs):
        if not request.user.is_authenticated:
            return redirect('login')
        if request.user.role != 'admin':
            return HttpResponseForbidden('无权访问')
        return view_func(request, *args, **kwargs)
    return wrapper
这里用的是自定义的 role 字段,不是 Django 内置的 is_staff。因为项目本身有"普通用户 / 管理员"两种角色的业务需求,用自定义字段能和业务逻辑保持一致。
数据聚合:能交给数据库就交给数据库
6 张图里,有 4 张直接在数据库层完成聚合。以分类占比为例:
def get_category_pie():
    data = Category.objects.filter(status='active').annotate(count=Count('products'))
    return [{'name': c.name, 'value': c.count} for c in data if c.count > 0]
annotate(Count('products')) 会生成一条带 GROUP BY 的 SQL,让 MySQL 直接算好每组的产品数量,而不是把几万行记录取回 Python 再数。
能这么写是因为模型里两个外键的 related_name 都叫 products:
class Product(models.Model):
    category = models.ForeignKey(Category, on_delete=models.PROTECT,
                                  related_name='products', db_column='category_id')
    origin = models.ForeignKey(Origin, on_delete=models.PROTECT,
                                related_name='products', db_column='origin_id')
所以 Count('products') 在 Category 和 Origin 上都能用,写起来很顺手。
另外 on_delete=models.PROTECT 也值得说一句。Django 默认是 CASCADE——删掉一个分类,下面所有产品会被连带删除。对电商数据来说这是灾难性的:手滑删了一个分类,几十个产品就没了。PROTECT 会在还有产品引用时直接拒绝删除,逼你先处理关联数据。
销量排行则是跨表分组:
def get_sales_ranking():
    data = OrderItem.objects.values('product__name').annotate(
        total_qty=Sum('quantity')
    ).order_by('-total_qty')[:10]
    return [{'name': d['product__name'], 'value': d['total_qty']} for d in data]
values('product__name') 加双下划线跨表取字段名,等价于 SQL 里的 JOIN + GROUP BY。注意这里的思路:不是统计"产品表里有哪些产品",而是从订单项出发累加销量——没卖出去的产品自然不出现,正好是排行榜想要的语义。
[:10] 是切片,生成的 SQL 带 LIMIT 10。排行榜永远只取前几名,没必要把全部数据取回来再截断。
前端:fetch → init → setOption
6 个图表的初始化代码结构完全一样,三步走:
async function initCategoryPie() {
    const res = await fetch('/admin/dashboard/api/category-pie');
    const {data} = await res.json();
    const chart = echarts.init(document.getElementById('categoryPie'));
    chart.setOption({
        title: {text: '农产品类别占比', left: 'center'},
        tooltip: {trigger: 'item', formatter: '{b}: {c}种 ({d}%)'},
        series: [{
            type: 'pie', radius: ['40%', '70%'],
            label: {formatter: '{b}\n{d}%'},
            data: data,
            itemStyle: {
                color: params => ['#27ae60','#2ecc71','#3498db','#f39c12',
                                   '#e74c3c','#9b59b6','#1abc9c','#e67e22'][params.dataIndex]
            }
        }]
    });
}
取数据、初始化实例、配置。ECharts 的 API 设计得很好——所有配置集中在一个 setOption() 里,想改什么改哪里,不用去调一堆 setter。
饼图这里用了 radius: ['40%', '70%'],第一个值是内半径,第二个是外半径。内半径不为 0 就是环形图(甜甜圈图)。相比实心饼图,中间留白能让视觉重心更集中在颜色分布上,标签也不会挤在中心。
多系列折线图和预测虚线
价格趋势这张图要同时画三条历史线(零售价、市场价、批发价)和一条预测虚线。难点在于:预测数据只有 3 个点,而历史数据有 12 个点,x 轴长度不一样。
const [trendRes, predRes] = await Promise.all([
    fetch('/admin/dashboard/api/price-trend?product_id=' + productId),
    fetch('/admin/dashboard/api/price-predict?product_id=' + productId)
]);
const {data} = await trendRes.json();
const predData = await predRes.json();

const allDates = [...data.dates, ...(predData.data ? predData.data.months : [])];
const predValues = predData.data
    ? [...new Array(data.dates.length).fill(null), ...predData.data.values]
    : [];
关键在于 predValues 这一行:用 null 把预测数据往前推,让它的第一个点正好落在历史数据最后一个点之后。
比如历史 12 个点、预测 3 个点,x 轴一共 15 个位置。预测数组就写成 [null × 12, 预测1, 预测2, 预测3]——前 12 个位置是空的,虚线的起点自然接在实线末尾。
ECharts 遇到 null 会跳过不画,不会连成一条掉到零点的线。这是处理"不同长度序列共享同一坐标轴"的标准技巧。
另外这里用了 Promise.all 并发请求两个接口,而不是先等一个再发下一个——两个请求互不依赖,串行没有意义。
中国地图
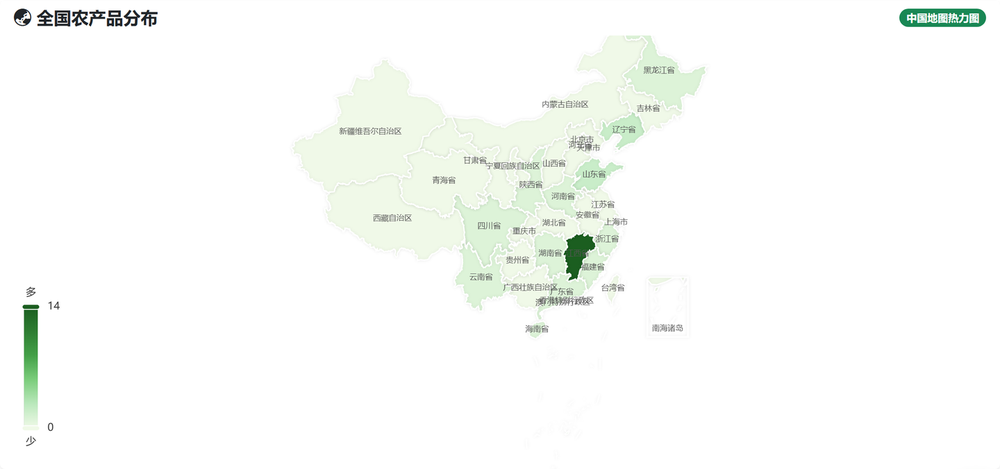
地图是 6 张图里最麻烦的。ECharts 从 5.0 开始不再内置地图数据,得自己去注册。
let chinaGeoJSON = null;
async function loadChinaMap() {
    const res = await fetch('https://geo.datav.aliyun.com/areas_v3/bound/100000_full.json');
    chinaGeoJSON = await res.json();
    echarts.registerMap('china', chinaGeoJSON);
}

async function initChinaMap() {
    if (!chinaGeoJSON) await loadChinaMap();
    const res = await fetch('/admin/dashboard/api/china-map');
    const {data} = await res.json();
    const maxVal = Math.max(...data.map(d => d.value), 1);
    const chart = echarts.init(document.getElementById('chinaMap'));
    // ...
}
GeoJSON 数据从阿里云 DataV 的公开接口拿,100000_full.json 是全国含完整省界的边界数据。拉回来之后用 echarts.registerMap('china', ...) 注册成一个叫 china 的地图,ECharts 就能用 type: 'map' 引用了。
if (!chinaGeoJSON) 这个判断是为了缓存——GeoJSON 文件有几百 KB,6 张图里只有地图用得到,但如果刷新或重新初始化,不该重复下载。
配色用的是连续型视觉映射:
visualMap: {
    min: 0,
    max: maxVal,
    calculable: true,
    inRange: {
        color: ['#f0f9e8', '#bae8bc', '#7bcd7b', '#43a047', '#2e7d32', '#1b5e20']
    },
    text: ['多', '少'],
}
inRange.color 给了 6 个从浅到深的绿色,ECharts 会自动在这 6 个色值之间插值,按每个省份的数据值映射到对应的颜色深浅。数据多的省份颜色深,一眼就能看出分布。
max: maxVal 是从数据里动态取的:Math.max(...data.map(d => d.value), 1)。最后那个 1 是兜底——如果所有省份都是 0(比如数据库为空),Math.max() 会返回 -Infinity,导致图表渲染异常。
三个问题,以及各自的解法
问题一:窗口一缩放,图表就变形了
问题在哪。ECharts 初始化时会把容器的像素尺寸读进来,之后不管容器怎么变,它画的还是原来那个尺寸。所以浏览器窗口一拉伸,图表不是被拉扁就是留一大块空白。
它不会自动监听尺寸变化——必须显式告诉它"重新量一下"。
怎么改。监听窗口的 resize 事件,调用 chart.resize():
const chart = echarts.init(document.getElementById('categoryPie'));
chart.setOption({ /* ... */ });

// 关键:保存实例,并在窗口变化时通知它重新计算尺寸
window.addEventListener('resize', () => chart.resize());
但这样每个图表都要绑一个监听器,6 个图就是 6 个。resize 事件触发非常频繁——拖动窗口时会连续触发几十上百次,每次都让 6 个图表重算,会明显卡顿。
标准做法是防抖:等用户停止拖动 200 毫秒后再统一处理。
let resizeTimer = null;
window.addEventListener('resize', () => {
    clearTimeout(resizeTimer);
    resizeTimer = setTimeout(() => {
        charts.forEach(c => c.resize());   // charts 是保存所有实例的数组
    }, 200);
});
思路是:每次触发都取消上一次的定时器,重新计时。连续拖动时定时器一直被打断,只有真正停下来 200ms 后才执行一次。
问题二:图表实例泄漏
问题在哪。现在每个初始化函数里,实例都只存在局部变量 const chart 里,函数一返回就没人引用了:
async function initCategoryPie() {
    const chart = echarts.init(document.getElementById('categoryPie'));
    chart.setOption({...});
}   // ← chart 在这里就脱离作用域了
当前用法下没什么后果——页面加载一次,图表画一次,不再重建。
但如果要做"切换产品刷新图表"这类交互,就会出问题。echarts.init() 在同一个 DOM 节点上调用两次,不会替换旧实例,而是在它上面叠加一个新的:旧实例还在监听事件、还占着内存,只是你看不见它了。切换十次就有十个僵尸实例。
怎么改。把实例统一存起来,重建前先销毁:
const charts = {};

function mountChart(id, option) {
    // 如果这个容器上已经有实例,先销毁
    if (charts[id]) {
        charts[id].dispose();
        delete charts[id];
    }
    const chart = echarts.init(document.getElementById(id));
    chart.setOption(option);
    charts[id] = chart;
    return chart;
}

// 重建时直接调用,不用关心有没有旧实例
async function initCategoryPie() {
    const res = await fetch('/admin/dashboard/api/category-pie');
    const {data} = await res.json();
    mountChart('categoryPie', {
        title: {text: '农产品类别占比', left: 'center'},
        series: [{type: 'pie', radius: ['40%', '70%'], data}]
    });
}这个模式有个名字叫幂等初始化——调用多少次结果都一样,调用方不需要知道"当前是什么状态"。凡是涉及"重新挂载"的场景,都应该这么设计。
另外 dispose() 是会释放 canvas 和事件监听的,比单纯把变量置空更彻底。只做 charts[id] = null 的话,实例依然挂在 DOM 节点上活着。
问题三:地图依赖别人的服务器
问题在哪。GeoJSON 从阿里云 DataV 拉:
const res = await fetch('https://geo.datav.aliyun.com/areas_v3/bound/100000_full.json');这条链路不受我控制。对方接口挂了、改路径了、或者哪天被限流了,我的地图就是一片空白——而错误只会在浏览器控制台里出现一行 fetch 失败,页面上看不出任何线索。
而且还有延迟:每次打开看板都要额外等一次跨域请求,几百 KB。
怎么改。把 GeoJSON 下载下来,放进自己的 static/ 目录:
# 下载一次
curl -o static/geo/china.json \
  https://geo.datav.aliyun.com/areas_v3/bound/100000_full.json
然后改成本地路径:
async function loadChinaMap() {
    const res = await fetch('/static/geo/china.json');
    echarts.registerMap('china', await res.json());
}
好处有三条:不再依赖第三方可用性;省掉一次跨域请求;可以由自己的缓存策略控制(Nginx 给静态文件加长缓存,浏览器以后就不用再下了)。
文件大概 400KB,放在服务器上完全可接受——而且它是静态的、不会变的数据,属于最适合本地化的那一类资源。行政区划真变了再更新一次就行。
判断标准很简单:不变的数据不该每次去问别人要。
一个不算问题的问题
统计卡片来自 Django 模板变量 {{ total_products }},图表数据来自 AJAX。一开始我经常搞混——改了 services.py 里的函数,刷新页面却发现卡片数字没变,因为那个数字根本不由 services.py 提供。
后来把这条界线记牢了:页面骨架上的数字是服务端给的,画在 canvas 里的是前端取的。
这不是 bug,是架构选择带来的必然代价。混合两种数据源能兼顾首屏速度和灵活性,但要求写代码的人时刻清楚"这个数字是从哪来的"。
小结
这个看板让我完整走了一遍"数据可视化"的链路:数据库聚合 → 接口封装 → 前端渲染。
最大的收获是理解了两种数据流的取舍:什么时候让服务端算好直接渲染(快、无需等待),什么时候异步取数据(灵活、可刷新)。以及一个贯穿始终的原则——能在数据库层做的聚合,就不要搬到 Python 里做。
遗留项:月度销售额不该在 Python 里算
6 张图里有 5 张都把聚合交给了数据库,只有一个例外——月度销售额:
def get_monthly_sales():
    orders = Order.objects.filter(
        status__in=['paid', 'shipping', 'shipped', 'completed']
    ).values('id', 'total_amount', 'created_at').order_by('created_at')

    monthly = defaultdict(float)
    for o in orders:
        if o['created_at']:
            key = o['created_at'].strftime('%Y-%m')
            monthly[key] += float(o['total_amount'])

return [{'month': k, 'value': round(v, 2)} for k, v in sorted(monthly.items())]它把所有订单全部取回 Python,再在内存里按月分组累加。数据量小的时候看不出问题,订单上万之后就是明显的浪费——几百毫秒的查询加上几十兆的内存,只为了算 12 个数字。
正确做法是把这个工作交回数据库。Django 提供了 TruncMonth,按月份截断日期时间:
from django.db.models import Sum
from django.db.models.functions import TruncMonth


def get_monthly_sales():
    data = (Order.objects
            .filter(status__in=['paid', 'shipping', 'shipped', 'completed'])
            .annotate(month=TruncMonth('created_at'))
            .values('month')
            .annotate(total=Sum('total_amount'))
            .order_by('month'))

    return [{'month': d['month'].strftime('%Y-%m'),
             'value': round(float(d['total']), 2)}
            for d in data if d['month']]
生成的 SQL 大致是 GROUP BY DATE_FORMAT(created_at, '%Y-%m-01')——数据库直接吐出 12 行结果,而不是把上万行原始数据搬到 Python 里再算。
有个小细节要注意:TruncMonth 返回的是「该月第一天」的日期(如 2026-09-01),所以最后还要 strftime('%Y-%m') 格式化成 2026-09。因为日期可能为 NULL,返回前加一个 if d['month'] 过滤。
这个改动只动了 5 行代码,但把一次 O(n) 的内存遍历变成了数据库层的分组聚合。这也正是前面那条原则的具体应用——能交给数据库的,就别自己算。
我暂时没改,因为当前订单量还小。但这是一个明确的优化方向,记录下来。
暂无评论