
写一个 Typecho 访问统计插件
博客上线之后,我很快想知道一件事:到底有没有人来看?
Typecho 本身不带访问统计。网上的方案要么是接第三方服务(百度统计、Google Analytics),要么是装别人写的插件。第三方服务会往页面里塞 JS,还会把你的访问数据存在别人服务器上;现成的插件则大多功能很重。最后我决定自己写一个——需求很简单,能记录、能看趋势就够了。
这篇文章讲这个插件的完整实现,代码大约 500 行。
先看看 Typecho 插件是怎么工作的
Typecho 的插件机制核心是钩子(Hook)。程序在关键位置预留了一些"挂载点",插件可以把自己的函数挂上去,事件触发时自动执行。
我要挂的钩子是 Widget\Archive 的 beforeRender——也就是"页面开始渲染之前"。这里正好是所有正常访问都会经过的地方。
class Plugin implements \Typecho\Plugin\PluginInterface
{
    public static function activate()
    {
        // 建表、挂钩子、注册菜单
    }

    public static function deactivate()
    {
        // 清理
    }
}
插件类要实现 PluginInterface,其中最关键的两个静态方法是 activate() 和 deactivate()——分别在后台点击"启用"和"禁用"时执行一次。
这是插件架构很典型的设计:把"一次性初始化"和"每次执行"分开。建表这种操作只该做一次,不能每次请求都跑。
建表
public static function activate()
{
    $db = \Typecho\Db::get();
    $prefix = $db->getPrefix();

    $db->query("CREATE TABLE IF NOT EXISTS `{$prefix}visitor_log` (
        `id` INT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
        `ip` VARCHAR(45) NOT NULL DEFAULT '',
        `url` VARCHAR(500) NOT NULL DEFAULT '',
        `referer` VARCHAR(500) NOT NULL DEFAULT '',
        `user_agent` VARCHAR(500) NOT NULL DEFAULT '',
        `created` INT UNSIGNED NOT NULL DEFAULT 0,
        INDEX `idx_created` (`created`),
        INDEX `idx_ip` (`ip`)
    ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4");

    \Typecho\Plugin::factory('Widget\Archive')->beforeRender = [__CLASS__, 'logVisit'];
    \Utils\Helper::addAction('visitor-log', __NAMESPACE__ . '\Action');
    \Utils\Helper::addPanel(1, 'VisitorLog/panel.php', '访问统计', '查看访问统计', 'administrator');
}
几个设计点:
表前缀从 $db->getPrefix() 动态取,不写死 typecho_。用户安装时如果改了前缀,插件照样能用。
ip 字段用 VARCHAR(45)。IPv4 最长 15 字符,但 IPv6 最长 45 字符,直接用 45 可以同时兼容两者。
建了两个索引。idx_created 用于按时间范围查询(统计今日、近 30 天),idx_ip 用于按 IP 聚合(算独立访客)。这两列正好是后面所有查询的过滤和分组条件。
记录一次访问
钩子挂上之后,每次页面渲染前都会调用 logVisit()。但这里有个问题:如果什么都记,数据很快就会被污染。
爬虫会疯狂地扫你的站点。如果不加过滤,你看到"今日访问 3000"然后发现其中 2980 次是百度的蜘蛛——这种统计没有任何意义。
所以我给插件做了两个开关,可以在后台配置:
public static function config(\Typecho\Widget\Helper\Form $form)
{
    $ignoreBots = new \Typecho\Widget\Helper\Form\Element\Radio(
        'ignoreBots', ['1' => '是', '0' => '否'], '1',
        '忽略搜索引擎爬虫',
        '建议开启,避免统计数据被爬虫污染'
    );
    $form->addInput($ignoreBots);

    $ignoreAdmin = new \Typecho\Widget\Helper\Form\Element\Radio(
        'ignoreAdmin', ['1' => '是', '0' => '否'], '1',
        '忽略已登录用户',
        '登录状态下的访问不记录'
    );
    $form->addInput($ignoreAdmin);
}第二个开关同样重要:我自己刷自己的博客不算访问。每改一次主题就刷新十几次页面,如果不排除,统计数据里有一半是我自己。
爬虫识别
识别爬虫最直接的办法是看 User-Agent:
private static function isBot($ua)
{
    $bots = [
        'bot', 'spider', 'crawler', 'scraper', 'curl', 'wget',
        'python', 'java/', 'go-http', 'php', 'perl',
        'googlebot', 'bingbot', 'yandex', 'baiduspider', 'sogou',
        '360spider', 'bytespider', 'petalbot', 'semrush',
        'ahrefsbot', 'dotbot', 'mj12bot', 'slurp', 'duckduckbot',
    ];
    $uaLower = strtolower($ua);
    foreach ($bots as $bot) {
        if (strpos($uaLower, $bot) !== false) return true;
    }
    return false;
}
列表分两类。前一组是通用关键词——几乎所有爬虫的 UA 里都带 bot、spider、crawler。后一组是具体名字,覆盖主流搜索引擎。
里面还夹了几个看起来不像爬虫的:curl、wget、python、go-http、php。这些是命令行工具和编程语言的默认 UA——正常浏览器不会用它们,出现即说明是脚本访问。
这是个简单粗暴的方案,弊端很明显:UA 是客户端随便填的,伪装一下就能绕过。但对于过滤常见爬虫来说够用了——真正的恶意访问不是这个统计插件要解决的问题。
顺带一个副作用:这样一来我自己的接口测试也会被自动排除。用 curl 调接口时不会污染统计,挺方便。
拿到真实 IP
这个比想象中麻烦。PHP 里最直接的 $_SERVER['REMOTE_ADDR'] 拿到的是直连服务器的那个 IP——如果站点前面挂了 CDN 或反向代理,拿到的就是 CDN 节点的 IP,所有访客看起来都来自同一个地方。
private static function getIp()
{
    $keys = ['HTTP_X_FORWARDED_FOR', 'HTTP_X_REAL_IP', 'HTTP_CLIENT_IP', 'REMOTE_ADDR'];
    foreach ($keys as $key) {
        if (!empty($_SERVER[$key])) {
            $ip = trim(explode(',', $_SERVER[$key])[0]);
            if (filter_var($ip, FILTER_VALIDATE_IP)) return $ip;
        }
    }
    return '0.0.0.0';
}
按优先级依次尝试,取第一个合法的:
X-Forwarded-For 是代理链的标准头,格式是 客户端IP, 代理1, 代理2,所以要用 explode(',') 取第一段——那才是原始客户端。
filter_var(..., FILTER_VALIDATE_IP) 不只是校验格式。它还能挡住一类攻击:这些 HTTP 头是客户端可以伪造的,有人会故意填 X-Forwarded-For: 恶意内容,如果不校验就直接存库,可能造成 XSS 或 SQL 注入问题。校验失败就跳到下一个来源。
最后兜底返回 0.0.0.0,保证字段永远有值,不会写入 NULL。
统计口径:PV 和 UV 到底是什么
这是做统计功能时最需要想清楚的——先定义清楚指标,再写代码。
我的定义很直接:
// 总访问量 (PV):所有记录条数
$totalVisits = $db->fetchObject($db->select(['COUNT(*)' => 'num'])->from($table))->num;

// 独立访客 (UV):按 IP 去重
$uniqueIPs = $db->fetchObject($db->select(['COUNT(DISTINCT ip)' => 'num'])->from($table))->num;

// 今日数据:加一个时间条件
$todayStart = strtotime(date('Y-m-d'));
$todayVisits = $db->fetchObject(
    $db->select(['COUNT(*)' => 'num'])->from($table)->where('created >= ?', $todayStart)
)->num;
PV 就是记录条数,每打开一个页面算一次,同一个人刷新十次就是 10。
UV 是 IP 去重后的数量。这里要诚实说明:我的 UV 口径是按 IP 算的,不是按浏览器或会话算的。
这意味着两件事:同一个人用手机和电脑访问,会被算成 2 个访客;同一个办公室或者同一个校园网出口下的多个人,会被算成 1 个访客。
业界标准做法是用 Cookie 或 localStorage 存一个随机 ID 来标识访客,能区分得更准。但那需要在访客浏览器里存东西,还要处理隐私问题。对一个个人博客的统计插件来说,IP 口径够用,代码也简单得多。
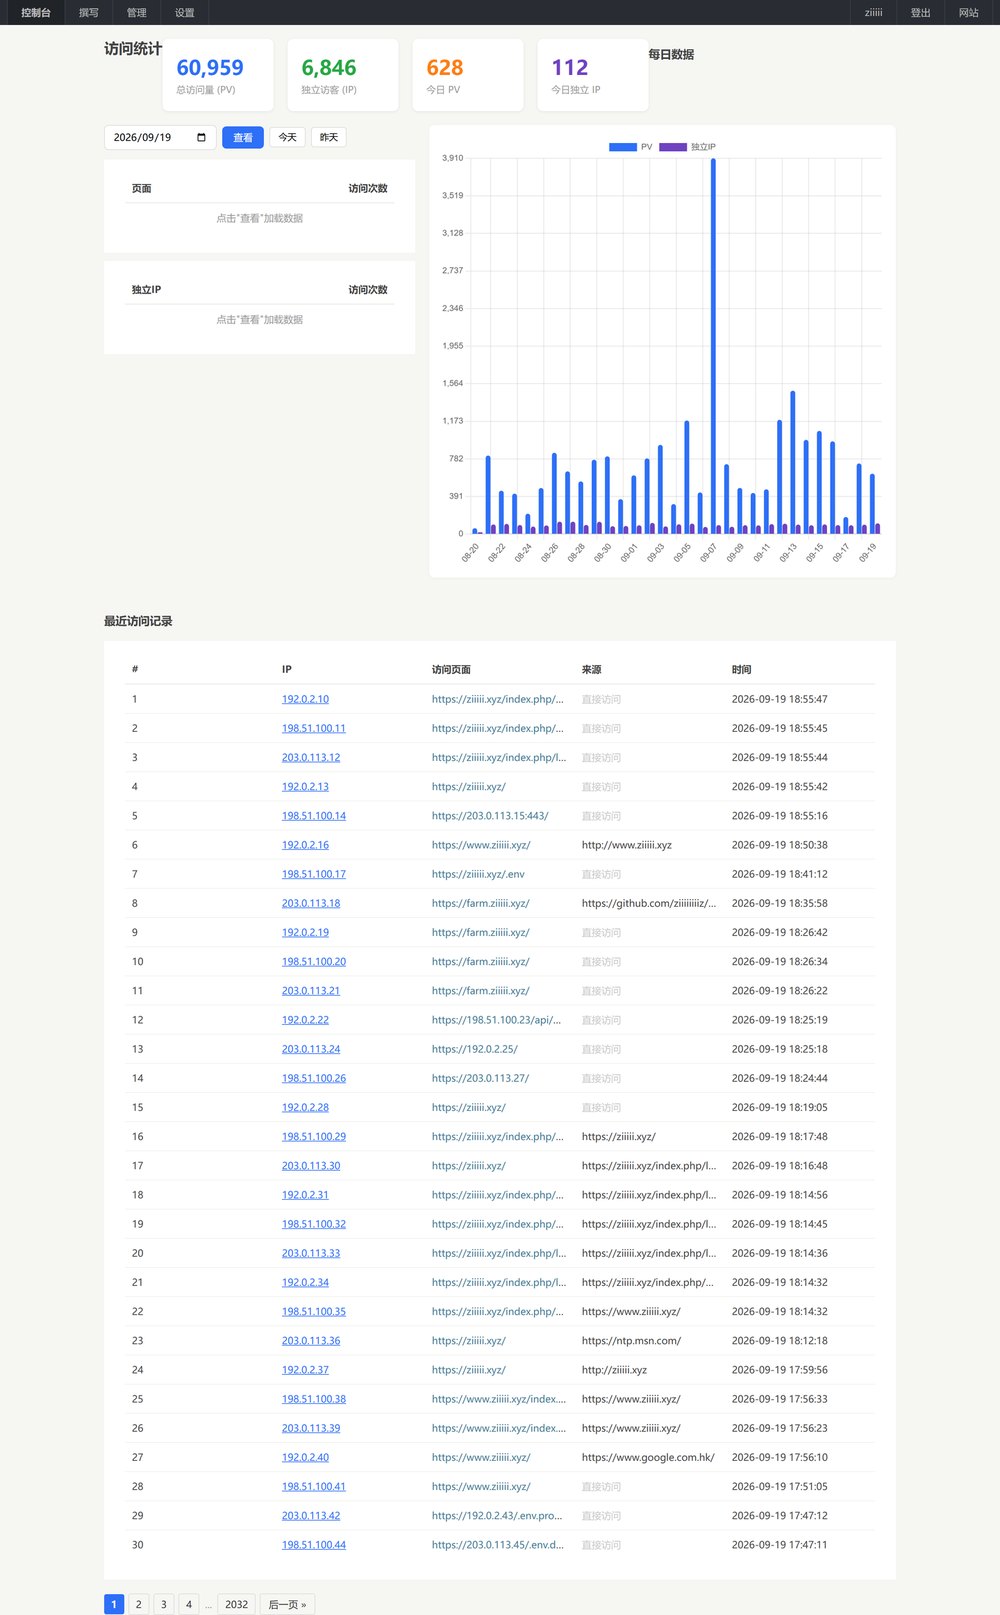
近 30 天趋势
面板上那张柱状图的数据来自一条聚合查询:
$thirtyDaysAgo = strtotime('-30 days');
$dailyStats = $db->fetchAll(
    $db->select(
        ['COUNT(*)' => 'count'],
        ['COUNT(DISTINCT ip)' => 'ips'],
        ['DATE(FROM_UNIXTIME(created))' => 'created_date']
    )
        ->from($table)
        ->where('created >= ?', $thirtyDaysAgo)
        ->group('DATE(FROM_UNIXTIME(created))')
        ->order('created', Typecho_Db::SORT_ASC)
);
关键在 group('DATE(FROM_UNIXTIME(created))') 这一句。
表里 created 存的是 Unix 时间戳(整数)。直接按它分组等于一条记录一组,没有意义。所以要先把时间戳还原成日期。
FROM_UNIXTIME() 是 MySQL 的函数,把时间戳转成日期时间;外面的 DATE() 再把时间部分截掉,只留 2026-09-19 这样的日期。同一个日期的所有记录就被归到一组了。
这样一次查询就能拿到 30 天的完整趋势,不用在 PHP 里循环 30 次查数据库。
后台面板
面板是一个独立的 PHP 文件,用 \Utils\Helper::addPanel() 注册到后台侧边栏。它继承 Typecho 后台的登录态——文件开头 include 'header.php'; include 'menu.php';,这两个文件会自动检查登录,未登录直接跳走。
\Utils\Helper::addPanel(1, 'VisitorLog/panel.php', '访问统计', '查看访问统计', 'administrator');最后一个参数 administrator 是访问权限级别,只有管理员能看到这个菜单。
图表用的是 Chart.js 4.4.0,从 CDN 引入,双数据集:PV 和独立 IP 并排显示在柱状图里。
另外做了一键查 IP 详情的功能——点击列表里的 IP,弹窗显示这个 IP 的所有访问记录(最多 200 条)、首次访问时间和最近访问时间。弹窗里还有一个跳转到外部 IP 归属地查询的链接。
三个问题,以及各自的解法
问题一:统计拖慢了每一个页面
问题在哪。我的钩子挂在 beforeRender 上——它在页面开始渲染之前触发。也就是说每个请求的处理顺序是:
请求进来 → 写统计记录(等一次数据库 INSERT)→ 渲染页面 → 返回那一次 INSERT 变成了页面响应时间的一部分。单看一次可能只有几毫秒,但它发生在每一次请求上,而且是串行的——用户必须等它写完才能看到页面。
更糟的是它还会加剧锁竞争:访问量大的时候,大量 INSERT 排队抢同一张表的锁,反而拖慢了读操作。
怎么改。Typecho 的 Archive 组件其实提供了两个钩子点:
// var/Widget/Archive.php
self::pluginHandle()->call('beforeRender', $this);   // 第 1387 行
// ... 渲染页面 ...
self::pluginHandle()->call('afterRender', $this);    // 第 1393 行
换成 afterRender,写入就挪到了页面渲染完成之后:
// 原来
\Typecho\Plugin::factory('Widget\Archive')->beforeRender = [__CLASS__, 'logVisit'];

// 改成
\Typecho\Plugin::factory('Widget\Archive')->afterRender = [__CLASS__, 'logVisit'];但这还不够——afterRender 触发时响应还没发给浏览器,INSERT 依然在用户的等待时间内。
真正让用户无感,要用 fastcgi_finish_request():
public static function logVisit($archive)
{
    // ... 前面照旧,先把要写的数据组装好 ...

    // 先把已生成的页面推给浏览器,并结束这次请求
    if (function_exists('fastcgi_finish_request')) {
        fastcgi_finish_request();
    }

    // 到这里浏览器已经拿到页面了,下面的写库在后台继续执行,
    // 不影响用户已经看到的响应
    $db->query($db->insert('table.visitor_log')->rows([...]));
}这个函数的作用是:把 PHP 已经产生的输出冲出去、关闭连接,但让 PHP 进程继续跑完剩下的代码。用户那边页面已经加载完了,统计记录还在慢慢写。
两个注意点:
一、它只在 PHP-FPM 下存在(Apache 的 mod_php 没有)。所以要用 function_exists() 判断,不存在就正常同步写——功能不受影响,只是没有这个优化。
二、调用它必须放在所有输出完成之后。如果提前调用,页面就会被截断。因为挂在 afterRender 上,此时模板已经渲染完毕,是安全的。
本站相册的上传接口也用了同样的手法——因为生成缩略图很慢,先把 JSON 结果返回给前端,图片处理在后台继续。
问题二:数据只增不减
问题在哪。插件只负责写,从来不清。每来一次访问就是一行,日积月累表会越来越大。
这不是"以后再说"的问题。表大了之后,面板首页那几条聚合查询(COUNT(*)、COUNT(DISTINCT ip))会越来越慢,最后拖垮整个后台。
用具体数字感受一下:一天 500 次访问,一年就是 18 万行。而 COUNT(DISTINCT ip) 在几十万行上是要实打实扫一遍的。
怎么改。分两步:先归档,再清理。
第一步,建一张按天汇总的表,把明细压缩成日均数据:
CREATE TABLE IF NOT EXISTS `typecho_visitor_daily` (
    `date`       DATE NOT NULL PRIMARY KEY,
    `pv`         INT UNSIGNED NOT NULL DEFAULT 0,
    `uv`         INT UNSIGNED NOT NULL DEFAULT 0,
    `updated_at` INT UNSIGNED NOT NULL DEFAULT 0
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
每天凌晨把前一天的数据汇总进去:
INSERT INTO typecho_visitor_daily (date, pv, uv, updated_at)
SELECT
    DATE(FROM_UNIXTIME(created)) AS d,
    COUNT(*)                     AS pv,
    COUNT(DISTINCT ip)           AS uv,
    UNIX_TIMESTAMP()             AS updated_at
FROM typecho_visitor_log
WHERE created >= UNIX_TIMESTAMP(CURDATE() - INTERVAL 1 DAY)
  AND created <  UNIX_TIMESTAMP(CURDATE())
GROUP BY d
ON DUPLICATE KEY UPDATE
    pv = VALUES(pv), uv = VALUES(uv), updated_at = VALUES(updated_at);
ON DUPLICATE KEY UPDATE 让这条语句可以重复执行——万一某天跑了两遍,结果一样,不会重复累加。定时任务一定要写成幂等的,否则某次重试就会把数据算错,而且很难发现。
第二步,归档完成之后再删明细,保留 90 天:
DELETE FROM typecho_visitor_log
WHERE created < UNIX_TIMESTAMP(CURDATE() - INTERVAL 90 DAY);
放到 crontab 里每天跑一次:
# 每天凌晨 3 点归档并清理
0 3 * * * mysql -u typecho -p'密码' typecho < /path/to/archive_visitor.sql
改成"明细 90 天 + 汇总永久"之后,表面上的数据量就封顶在几万行,再也不用担心它无限增长。而趋势图需要的本来就是按天的聚合数据,明细反而用不上。
删除要留着分批做。DELETE 几十万行会长时间占着锁,把正常的访问写入堵住。数据量特别大时应该写成循环,每次删几千行,中间歇一下。
问题三:UV 被低估
问题在哪。我用 COUNT(DISTINCT ip) 算独立访客,等于假设"一个 IP = 一个人"。这个假设在两个方向上都站不住:
同一个办公室或学校,几十台设备共用出口 IP,会被算成 1 个人。同一个人的手机和电脑换着用,会被算成 2 个人。
我是在面板上看到某个 IP 一天访问几百次才意识到这个问题的——那大概率是某个机构的共享出口。
怎么改。用 Cookie 给每个访客发一个随机 ID,按 ID 去重:
// 生成一个随机访客 ID,存一年
if (empty($_COOKIE['visitor_uid'])) {
    $uid = bin2hex(random_bytes(16));
    setcookie('visitor_uid', $uid, [
        'expires'  => time() + 31536000,
        'path'     => '/',
        'secure'   => true,
        'httponly' => true,
        'samesite' => 'Lax',
    ]);
} else {
    $uid = $_COOKIE['visitor_uid'];
}

// 用它替代原来的 IP 维度
$uniqueVisitors = $db->fetchObject(
    $db->select(['COUNT(DISTINCT visitor_uid)' => 'num'])->from($table)
)->num;
表里相应加一列:
ALTER TABLE typecho_visitor_log
    ADD COLUMN visitor_uid CHAR(32) NOT NULL DEFAULT '',
    ADD INDEX idx_uid (visitor_uid);
bin2hex(random_bytes(16)) 生成一个 32 位的随机十六进制串。用 random_bytes() 而不是 rand() 很重要——前者是密码学安全的随机源,生成的 ID 不可预测,不会被别人伪造。
这个方案有代价,必须说清楚:它需要在访客的浏览器里存东西。涉及隐私合规的站点,得在隐私政策里声明,欧洲的站点还要考虑 GDPR。个人博客一般没这个负担,但知道代价在哪是必要的。
改造之后 UV 的含义变了:从"多少个不同 IP"变成"多少个不同浏览器"。更接近真实的独立访客数,但也意味着清空 Cookie 就会被算成新访客。
更好的做法是两个数都记。IP 仍然存着(用于排查异常访问),但面板上的"独立访客"改用 UID 口径。IP 反映的是网络来源,UID 反映的是人,两者各有各的用途。
小结
这个插件让我第一次完整地写了一个 Typecho 插件:从钩子机制、插件生命周期、到后台面板注册。500 行左右的代码,覆盖了插件开发的主要环节。
更有意思的是它逼我想清楚了两件事:统计口径怎么定义(PV 和 UV 到底算什么),以及数据质量怎么保证(不加过滤的统计等于没有统计)。
而上面那三个问题——写入阻塞、数据无限增长、UV 口径失真——它们有个共同点:功能上都"正常",但都经不起规模考验。
插件刚上线时这一切都看不出来:表里只有几百行,查询很快;访问量小,写入延迟可以忽略;一天几十个访客,UV 准不准也感觉不到。问题都是在数据积累之后才浮现的,而这时候往往已经积累了几个月。
所以写这类"基础设施"性质的代码时,我会强迫自己多想一步:数据量涨到一百倍时,这段代码会先在哪里出问题?
这三个问题里,第一个(阻塞写入)我在写的时候完全没意识到;第二个(数据增长)我知道但选择了拖延;第三个(UV 口径)是我看到异常数据才发现的——三种典型情况都碰上了。
暂无评论